

Commit ·
0fd5974
0
Parent(s):
initial commit
Browse files- .gitattributes +42 -0
- README.md +138 -0
- SHA256SUMS +8 -0
- Spark-X2.6-4B-BF16.gguf +3 -0
- Spark-X2.6-4B-Q4_0.gguf +3 -0
- Spark-X2.6-4B-Q4_K_M.gguf +3 -0
- Spark-X2.6-4B-Q5_K_M.gguf +3 -0
- Spark-X2.6-4B-Q6_K.gguf +3 -0
- Spark-X2.6-4B-Q8_0.gguf +3 -0
- assets/benchmark.png +3 -0
- spark-x2.6-4b-NVFP4.safetensors +3 -0
- spark-x2.6-4b-fp8.safetensors +3 -0
.gitattributes
ADDED
|
@@ -0,0 +1,42 @@
|
|
|
|
|
|
|
|
|
|
|
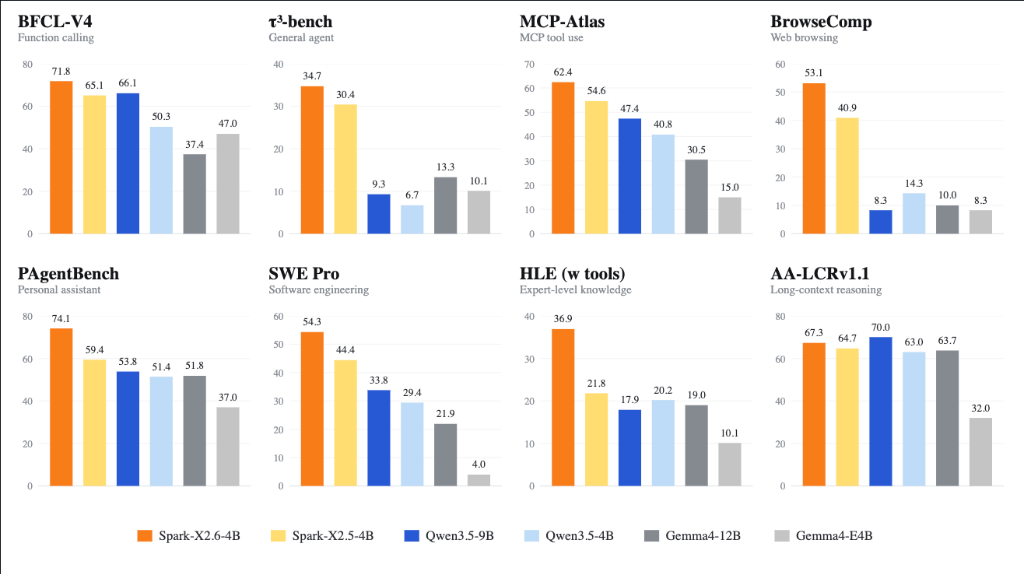
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
*.7z filter=lfs diff=lfs merge=lfs -text
|
| 2 |
+
*.arrow filter=lfs diff=lfs merge=lfs -text
|
| 3 |
+
*.bin filter=lfs diff=lfs merge=lfs -text
|
| 4 |
+
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
| 5 |
+
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
| 6 |
+
*.ftz filter=lfs diff=lfs merge=lfs -text
|
| 7 |
+
*.gz filter=lfs diff=lfs merge=lfs -text
|
| 8 |
+
*.h5 filter=lfs diff=lfs merge=lfs -text
|
| 9 |
+
*.joblib filter=lfs diff=lfs merge=lfs -text
|
| 10 |
+
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
| 11 |
+
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
| 12 |
+
*.model filter=lfs diff=lfs merge=lfs -text
|
| 13 |
+
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
| 14 |
+
*.npy filter=lfs diff=lfs merge=lfs -text
|
| 15 |
+
*.npz filter=lfs diff=lfs merge=lfs -text
|
| 16 |
+
*.onnx filter=lfs diff=lfs merge=lfs -text
|
| 17 |
+
*.ot filter=lfs diff=lfs merge=lfs -text
|
| 18 |
+
*.parquet filter=lfs diff=lfs merge=lfs -text
|
| 19 |
+
*.pb filter=lfs diff=lfs merge=lfs -text
|
| 20 |
+
*.pickle filter=lfs diff=lfs merge=lfs -text
|
| 21 |
+
*.pkl filter=lfs diff=lfs merge=lfs -text
|
| 22 |
+
*.pt filter=lfs diff=lfs merge=lfs -text
|
| 23 |
+
*.pth filter=lfs diff=lfs merge=lfs -text
|
| 24 |
+
*.rar filter=lfs diff=lfs merge=lfs -text
|
| 25 |
+
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
| 26 |
+
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
| 27 |
+
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
| 28 |
+
*.tar filter=lfs diff=lfs merge=lfs -text
|
| 29 |
+
*.tflite filter=lfs diff=lfs merge=lfs -text
|
| 30 |
+
*.tgz filter=lfs diff=lfs merge=lfs -text
|
| 31 |
+
*.wasm filter=lfs diff=lfs merge=lfs -text
|
| 32 |
+
*.xz filter=lfs diff=lfs merge=lfs -text
|
| 33 |
+
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
+
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
+
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
assets/benchmark.png filter=lfs diff=lfs merge=lfs -text
|
| 37 |
+
Spark-X2.6-4B-Q4_0.gguf filter=lfs diff=lfs merge=lfs -text
|
| 38 |
+
Spark-X2.6-4B-Q4_K_M.gguf filter=lfs diff=lfs merge=lfs -text
|
| 39 |
+
Spark-X2.6-4B-Q5_K_M.gguf filter=lfs diff=lfs merge=lfs -text
|
| 40 |
+
Spark-X2.6-4B-Q6_K.gguf filter=lfs diff=lfs merge=lfs -text
|
| 41 |
+
Spark-X2.6-4B-Q8_0.gguf filter=lfs diff=lfs merge=lfs -text
|
| 42 |
+
Spark-X2.6-4B-BF16.gguf filter=lfs diff=lfs merge=lfs -text
|
README.md
ADDED
|
@@ -0,0 +1,138 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
---
|
| 2 |
+
license: apache-2.0
|
| 3 |
+
base_model:
|
| 4 |
+
- XHToken/Spark-X2.6-4B
|
| 5 |
+
base_model_relation: quantized
|
| 6 |
+
pipeline_tag: text-generation
|
| 7 |
+
library_name: gguf
|
| 8 |
+
language:
|
| 9 |
+
- en
|
| 10 |
+
- zh
|
| 11 |
+
tags:
|
| 12 |
+
- gguf
|
| 13 |
+
- safetensors
|
| 14 |
+
- fp8
|
| 15 |
+
- nvfp4
|
| 16 |
+
- spark
|
| 17 |
+
- spark2_5
|
| 18 |
+
- spark-x2.6
|
| 19 |
+
- text-generation
|
| 20 |
+
- reasoning
|
| 21 |
+
- agent
|
| 22 |
+
- llama-cpp
|
| 23 |
+
- ollama
|
| 24 |
+
---
|
| 25 |
+
|
| 26 |
+
[](https://abenzerps.com/request-a-model/)
|
| 27 |
+
|
| 28 |
+
# Spark-X2.6-4B Quantized
|
| 29 |
+
|
| 30 |
+
GGUF and Safetensors (FP8, NVFP4) quantized variants of [XHToken/Spark-X2.6-4B](https://huggingface.co/XHToken/Spark-X2.6-4B) for local execution, agent workflows, and reasoning.
|
| 31 |
+
|
| 32 |
+
**Spark-X2.6-4B** by [XHToken](https://huggingface.co/XHToken) is a lightweight 4B language model optimized for on-device agents, coding, and tool use. Featuring a hybrid-attention design with up to a 1M context window and controllable thinking budgets (`low` / `high`), it matches or outperforms much larger 9B–12B models on standard agent and coding benchmarks while remaining exceptionally fast.
|
| 33 |
+
|
| 34 |
+
## Benchmark
|
| 35 |
+
|
| 36 |
+

|
| 37 |
+
|
| 38 |
+
## Quantized Files
|
| 39 |
+
|
| 40 |
+
| **Quantization** | **File** | **Size** |
|
| 41 |
+
| --- | --- | ---: |
|
| 42 |
+
| FP8 | [**spark-x2.6-4b-fp8.safetensors**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/spark-x2.6-4b-fp8.safetensors) | 4.14 GB |
|
| 43 |
+
| NVFP4 | [**spark-x2.6-4b-NVFP4.safetensors**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/spark-x2.6-4b-NVFP4.safetensors) | 2.60 GB |
|
| 44 |
+
| BF16 | [**Spark-X2.6-4B-BF16.gguf**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/Spark-X2.6-4B-BF16.gguf) | 7.66 GB |
|
| 45 |
+
| Q8_0 | [**Spark-X2.6-4B-Q8_0.gguf**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/Spark-X2.6-4B-Q8_0.gguf) | 4.10 GB |
|
| 46 |
+
| Q6_K | [**Spark-X2.6-4B-Q6_K.gguf**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/Spark-X2.6-4B-Q6_K.gguf) | 3.20 GB |
|
| 47 |
+
| Q5_K_M | [**Spark-X2.6-4B-Q5_K_M.gguf**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/Spark-X2.6-4B-Q5_K_M.gguf) | 2.80 GB |
|
| 48 |
+
| Q4_K_M | [**Spark-X2.6-4B-Q4_K_M.gguf**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/Spark-X2.6-4B-Q4_K_M.gguf) | 2.47 GB |
|
| 49 |
+
| Q4_0 | [**Spark-X2.6-4B-Q4_0.gguf**](https://huggingface.co/abenzerps/Spark-X2.6-4B-Quantized/blob/main/Spark-X2.6-4B-Q4_0.gguf) | 2.24 GB |
|
| 50 |
+
|
| 51 |
+
**Q4_K_M** is recommended for the best balance of size and quality for GGUF. **NVFP4** and **FP8** offer high performance on supported NVIDIA GPUs.
|
| 52 |
+
|
| 53 |
+
## Usage
|
| 54 |
+
|
| 55 |
+
### 1. llama.cpp / llama-server (GGUF)
|
| 56 |
+
|
| 57 |
+
#### Interactive Chat via CLI
|
| 58 |
+
Run multi-turn interactive conversation directly in your terminal:
|
| 59 |
+
|
| 60 |
+
```bash
|
| 61 |
+
./llama-cli -m Spark-X2.6-4B-Q4_K_M.gguf \
|
| 62 |
+
-cnv \
|
| 63 |
+
-c 8192 \
|
| 64 |
+
-n 512 \
|
| 65 |
+
--temp 0.6 \
|
| 66 |
+
-t 8
|
| 67 |
+
```
|
| 68 |
+
|
| 69 |
+
#### OpenAI-Compatible API Server
|
| 70 |
+
Start `llama-server` to serve OpenAI-compatible `/v1/chat/completions` endpoints:
|
| 71 |
+
|
| 72 |
+
```bash
|
| 73 |
+
./llama-server -m Spark-X2.6-4B-Q4_K_M.gguf \
|
| 74 |
+
-c 8192 \
|
| 75 |
+
--port 8080
|
| 76 |
+
```
|
| 77 |
+
|
| 78 |
+
Query via curl:
|
| 79 |
+
|
| 80 |
+
```bash
|
| 81 |
+
curl http://localhost:8080/v1/chat/completions \
|
| 82 |
+
-H "Content-Type: application/json" \
|
| 83 |
+
-d '{
|
| 84 |
+
"messages": [
|
| 85 |
+
{
|
| 86 |
+
"role": "user",
|
| 87 |
+
"content": "Hello! What can you help me with?"
|
| 88 |
+
}
|
| 89 |
+
],
|
| 90 |
+
"temperature": 0.6
|
| 91 |
+
}'
|
| 92 |
+
```
|
| 93 |
+
|
| 94 |
+
### 2. Ollama (GGUF)
|
| 95 |
+
|
| 96 |
+
Create a `Modelfile`:
|
| 97 |
+
|
| 98 |
+
```dockerfile
|
| 99 |
+
FROM ./Spark-X2.6-4B-Q4_K_M.gguf
|
| 100 |
+
|
| 101 |
+
TEMPLATE """{{- if .System }}<|start▁of▁sentence|><|System|>{{ .System }}
|
| 102 |
+
{{ end }}{{- range .Messages }}<|start▁of▁sentence|><|{{ if eq .Role "user" }}User{{ else }}Bot{{ end }}|>{{ .Content }}<|end▁of▁sentence|>{{- end }}{{- if .Prompt }}<|start▁of▁sentence|><|User|>{{ .Prompt }}<|end▁of▁sentence|><|start▁of▁sentence|><|Bot|><think>
|
| 103 |
+
{{ end }}"""
|
| 104 |
+
|
| 105 |
+
PARAMETER stop "<|end▁of▁sentence|>"
|
| 106 |
+
PARAMETER stop "<|start▁of▁sentence|>"
|
| 107 |
+
PARAMETER temperature 0.6
|
| 108 |
+
```
|
| 109 |
+
|
| 110 |
+
Build and run:
|
| 111 |
+
|
| 112 |
+
```bash
|
| 113 |
+
ollama create spark-x2.6 -f Modelfile
|
| 114 |
+
ollama run spark-x2.6
|
| 115 |
+
```
|
| 116 |
+
|
| 117 |
+
### 3. NVIDIA FP8 & NVFP4 (Safetensors)
|
| 118 |
+
|
| 119 |
+
Load the quantized weights directly via `safetensors` for TensorCore-accelerated pipelines (such as `comfy-kitchen`, `vLLM`, or custom inference):
|
| 120 |
+
|
| 121 |
+
```python
|
| 122 |
+
import safetensors.torch
|
| 123 |
+
import torch
|
| 124 |
+
|
| 125 |
+
# Load FP8 (torch.float8_e4m3fn with per-tensor scales)
|
| 126 |
+
fp8_weights = safetensors.torch.load_file("spark-x2.6-4b-fp8.safetensors")
|
| 127 |
+
|
| 128 |
+
# Load NVFP4 (packed 4-bit with block-wise scales)
|
| 129 |
+
nvfp4_weights = safetensors.torch.load_file("spark-x2.6-4b-NVFP4.safetensors")
|
| 130 |
+
```
|
| 131 |
+
|
| 132 |
+
## Source and Build
|
| 133 |
+
|
| 134 |
+
- **Source model:** [XHToken/Spark-X2.6-4B](https://huggingface.co/XHToken/Spark-X2.6-4B)
|
| 135 |
+
- **Architecture:** `Spark2_5ForCausalLM` (`spark2_5` GGUF architecture)
|
| 136 |
+
- **Conversion & Quantization:** Upstream [llama.cpp](https://github.com/ggml-org/llama.cpp) & [comfy-kitchen](https://github.com/comfyanonymous/comfy-kitchen)
|
| 137 |
+
- **License:** Apache 2.0
|
| 138 |
+
- **Checksums:** [SHA256SUMS](./SHA256SUMS)
|
SHA256SUMS
ADDED
|
@@ -0,0 +1,8 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
147623442b41fdd68dc3f9ea843ca6dcc325c14f29c263ecdfc9c92048297547 Spark-X2.6-4B-Q6_K.gguf
|
| 2 |
+
27a3209da7815b77c73bd4e58a3c76b8801baa81f67f21c99ed6ebb30934a1f3 spark-x2.6-4b-fp8.safetensors
|
| 3 |
+
3e6b74bcf43286fadac61c74277554271ef10a59c80263d8f58fd6cbdff517a1 Spark-X2.6-4B-Q8_0.gguf
|
| 4 |
+
798bbfe2cbf564c779c7213a4f4e2f5b9f70b8d7740cc2ad12b992dba3001224 Spark-X2.6-4B-Q4_K_M.gguf
|
| 5 |
+
874a8e72f893549bcf3de7cc0e26ef4f423584c1eb38eb3b38538d197ebbc71a Spark-X2.6-4B-BF16.gguf
|
| 6 |
+
8907bb53fe156f51a9c2eb10a724388eaa55aac0a1b9e4738c1a0de03ad407cd Spark-X2.6-4B-Q5_K_M.gguf
|
| 7 |
+
97221a1aa8336763cb2a1fde88e18cb81681f93e04934348243bc737f45cd3f6 spark-x2.6-4b-NVFP4.safetensors
|
| 8 |
+
f4cec54f9fc99bb18c1fc7d0f5f3dfc802d22d0cd9853b3908d80a8d82317ec7 Spark-X2.6-4B-Q4_0.gguf
|
Spark-X2.6-4B-BF16.gguf
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:874a8e72f893549bcf3de7cc0e26ef4f423584c1eb38eb3b38538d197ebbc71a
|
| 3 |
+
size 8229921120
|
Spark-X2.6-4B-Q4_0.gguf
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:f4cec54f9fc99bb18c1fc7d0f5f3dfc802d22d0cd9853b3908d80a8d82317ec7
|
| 3 |
+
size 2405583200
|
Spark-X2.6-4B-Q4_K_M.gguf
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:798bbfe2cbf564c779c7213a4f4e2f5b9f70b8d7740cc2ad12b992dba3001224
|
| 3 |
+
size 2600225120
|
Spark-X2.6-4B-Q5_K_M.gguf
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:8907bb53fe156f51a9c2eb10a724388eaa55aac0a1b9e4738c1a0de03ad407cd
|
| 3 |
+
size 2977896800
|
Spark-X2.6-4B-Q6_K.gguf
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:147623442b41fdd68dc3f9ea843ca6dcc325c14f29c263ecdfc9c92048297547
|
| 3 |
+
size 3379172960
|
Spark-X2.6-4B-Q8_0.gguf
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:3e6b74bcf43286fadac61c74277554271ef10a59c80263d8f58fd6cbdff517a1
|
| 3 |
+
size 4375021920
|
assets/benchmark.png
ADDED
|
Git LFS Details
|
spark-x2.6-4b-NVFP4.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:97221a1aa8336763cb2a1fde88e18cb81681f93e04934348243bc737f45cd3f6
|
| 3 |
+
size 2796385792
|
spark-x2.6-4b-fp8.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:27a3209da7815b77c73bd4e58a3c76b8801baa81f67f21c99ed6ebb30934a1f3
|
| 3 |
+
size 4447867080
|