# UltraData-SFT-Agent-2609
📦 UltraData 合集 |
🌐 UltraData |
🤗 MiniCPM5 系列
English |
中文
## 📚 简介
***UltraData-SFT-Agent-2609*** 是 [UltraData](https://ultradata.openbmb.cn/) [L0-L4 分级数据管理框架](https://arxiv.org/pdf/2602.09003/) 面向 Agent 指令微调的 **L3 合成与增强数据**。面向 [MiniCPM5-2B](https://huggingface.co/openbmb/MiniCPM5-2B) 后训练构建,作为 [UltraData-SFT-2605](https://huggingface.co/datasets/openbmb/UltraData-SFT-2605)(核心领域 SFT)在可执行 Agent 轨迹上的补充。发布约 **50 万**条样本,覆盖工具调用、Search Agent、Code Agent 和 General Agent,贯穿指令理解、工具调用、环境交互、结果验证、错误恢复到最终交付的完整工作流。
数据集覆盖技能检索与调用、网页搜索与多跳问答、软件工程和代码执行、Office 文档处理、通用函数调用、多轮记忆、金融服务、数据库操作、文件读写和多模态内容处理等任务形态,以及从技能调用、文件操作到文档和办公流程执行的综合工作流。任务既包括单步或短链路指令执行,也包括需要持续规划、反复调用工具、处理执行反馈并进行阶段性验证的长链路任务,形成由基础工具使用到复杂 Agent 协作的梯度化任务分布。
## 📢 最新动态
- **[2026.09.07]** [***UltraData-SFT-Agent-2609***](https://huggingface.co/datasets/openbmb/UltraData-SFT-Agent-2609) 数据集正式发布!面向 **[MiniCPM5-2B](https://huggingface.co/openbmb/MiniCPM5-2B) 后训练**的 Agent 指令微调轨迹,属于 [UltraData](https://ultradata.openbmb.cn/) [L0-L4 框架](https://arxiv.org/pdf/2602.09003) 中的 **L3 合成与增强数据**,约 50 万条,覆盖工具调用、Search Agent、Code Agent 和 General Agent。🚀🚀🚀
- **[2026.09.07]** ***[MiniCPM5-2B](https://huggingface.co/openbmb/MiniCPM5-2B) 正式发布!*** 作为 MiniCPM5 系列在 MiniCPM5-1B 之后的第二款模型,这是一款沿用同一套训练配方放大的 2B 稠密 Transformer,面向端侧、本地部署与资源受限场景,达到 **2B 级开源 SOTA**,整体可与 4B 级模型竞争,并在代码、数学、长上下文、工具调用与 Agent 任务上相对同规模模型更具优势。UltraData-SFT-Agent-2609 是 MiniCPM5-2B 的核心 Agent SFT 数据。🚀🚀🚀
- **[2026.02.08]** [***UltraData***](https://ultradata.openbmb.cn/) 平台正式上线,并发布 [L0-L4 分级数据管理框架](https://arxiv.org/pdf/2602.09003)。🔍🔍🔍
## 🎯 数据规模与能力覆盖
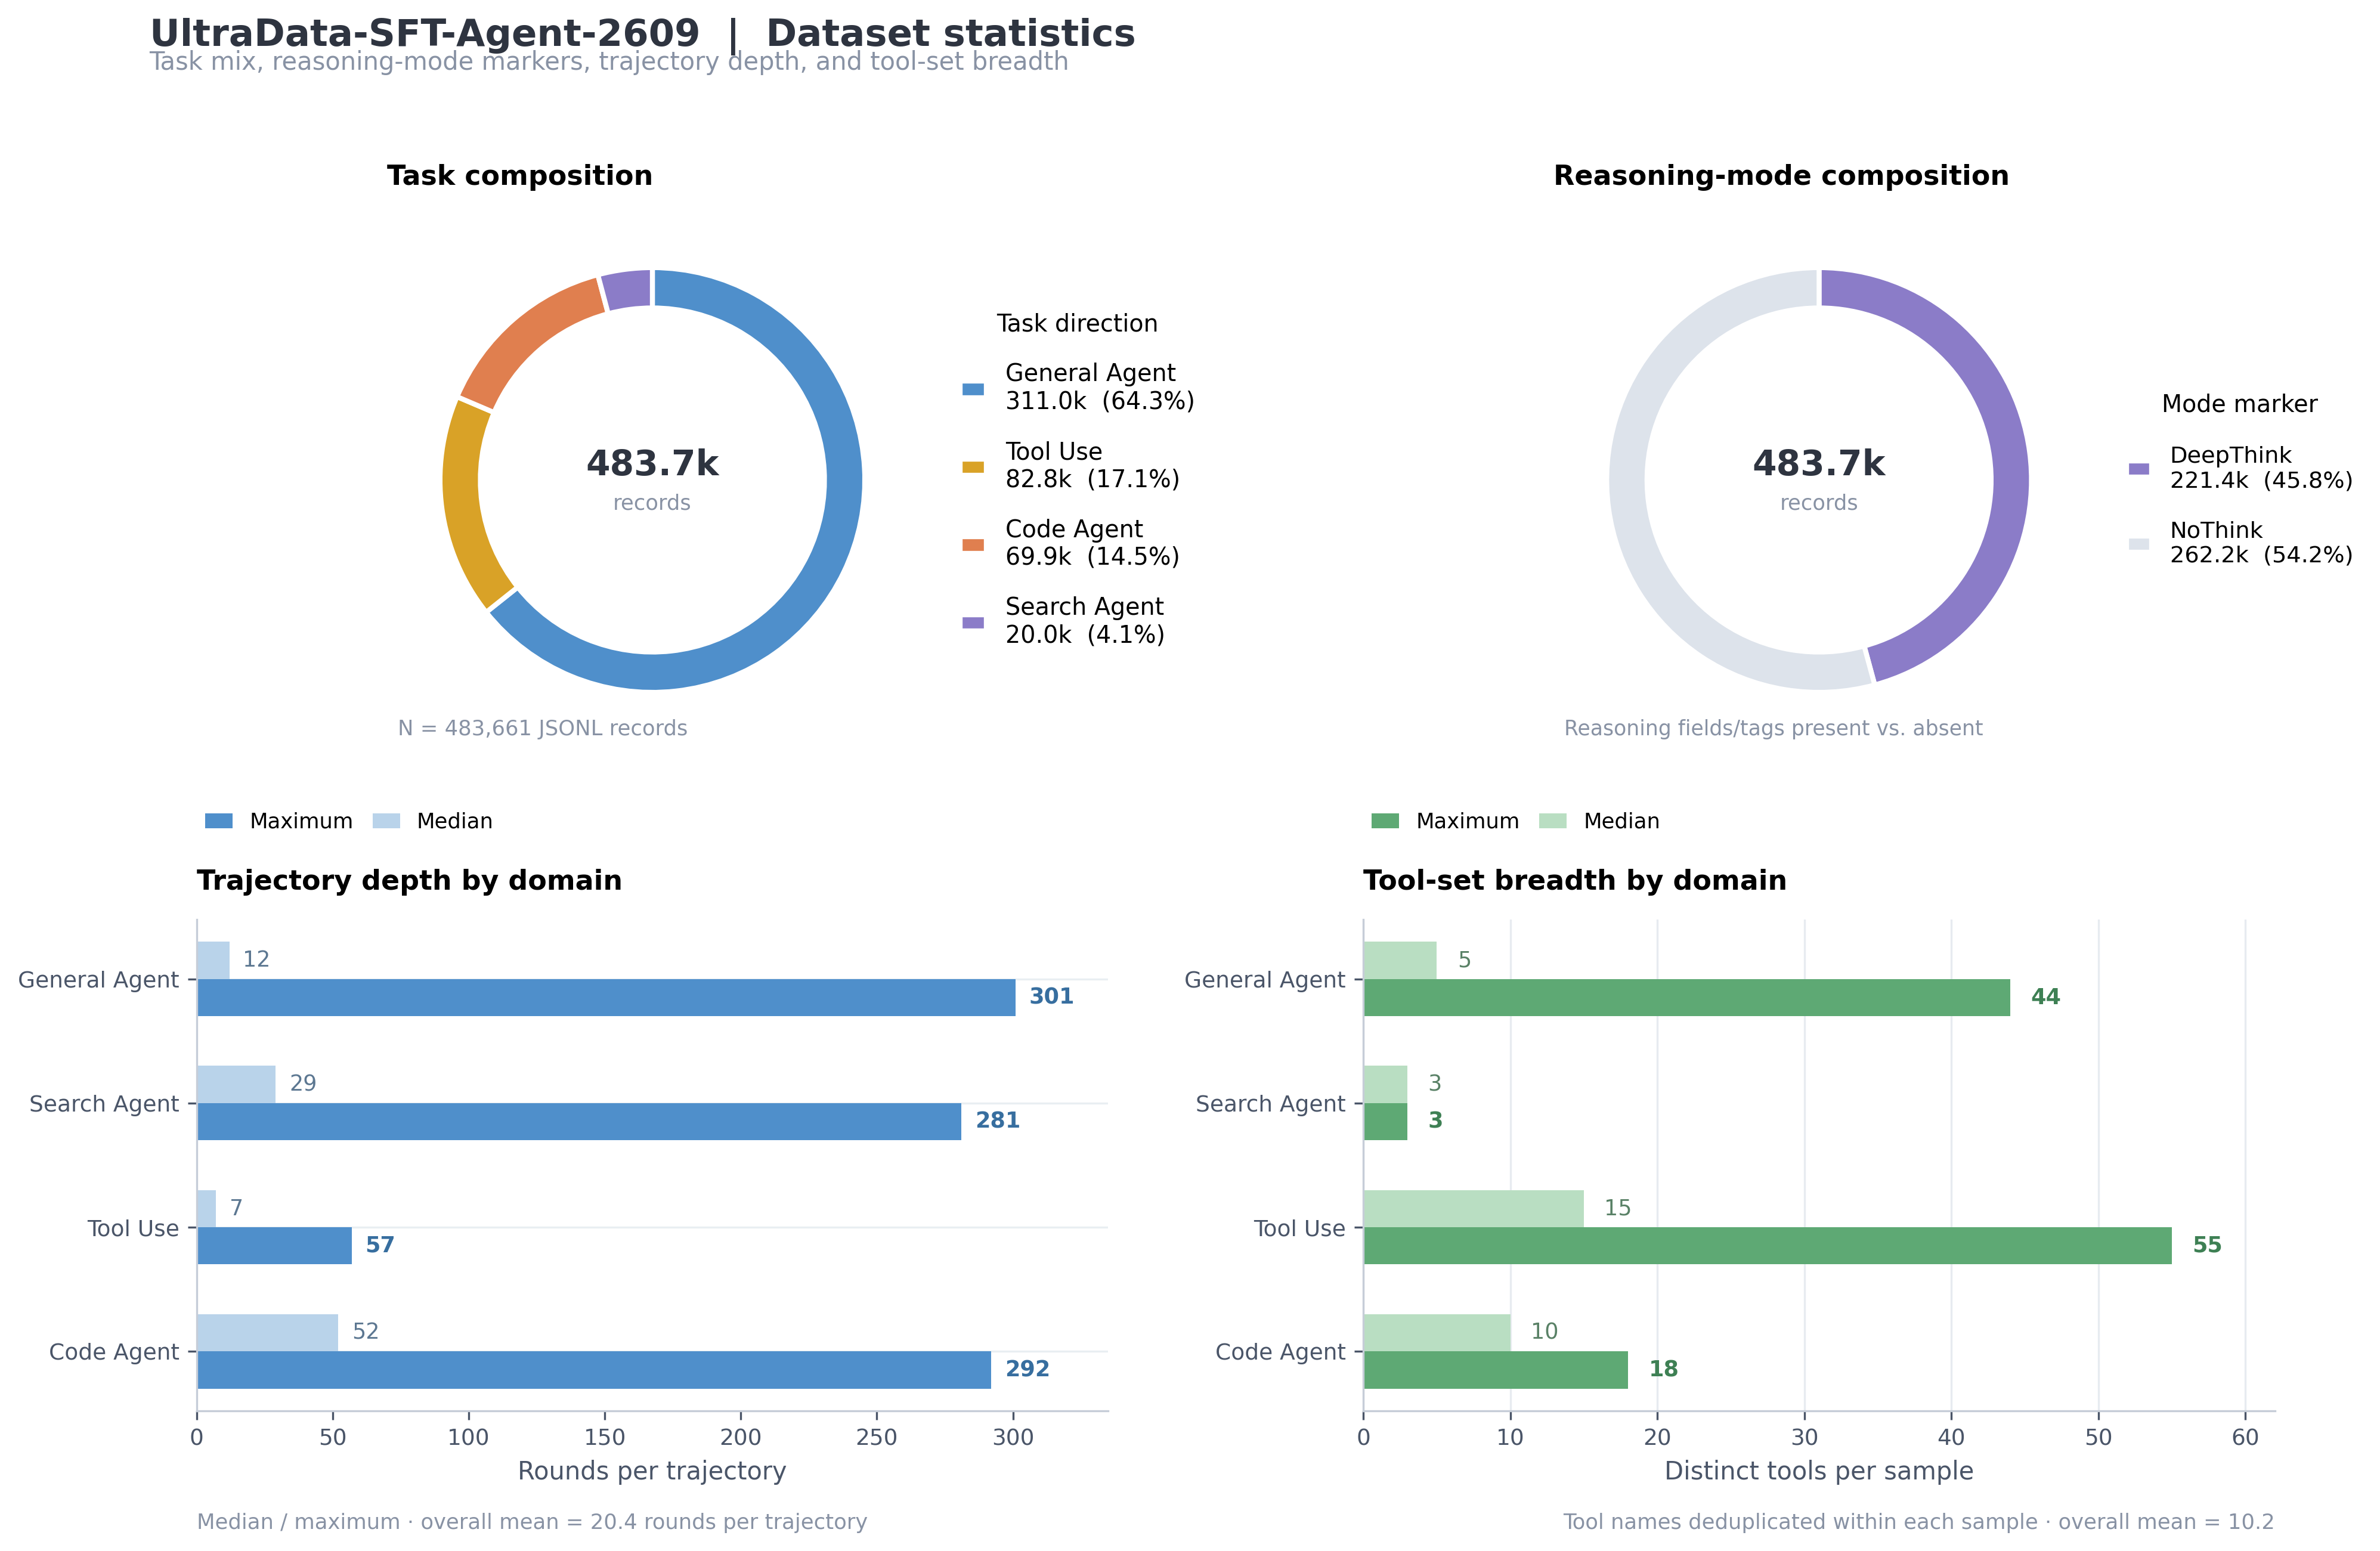
发布版本共 **483,661** 条轨迹,覆盖四个 Agent 方向。部分 **General-Agent** 与 **Code-Agent** 任务在多个 harness 下复采样,因此统计的是轨迹条数,而非独立任务数。
| Agent 方向 | 样本数 | 占比 | 主要内容 |
|:---|---:|---:|:---|
| **General-Agent** | 311,006 | 64.3% | 技能检索与调用、Office / 文件工作流、多 harness 综合任务 |
| **Tool-Use** | 82,760 | 17.1% | 函数调用、虚拟工具、数据库、金融业务流程、多轮工具交互 |
| **Code-Agent** | 69,895 | 14.5% | 软件工程、代码修改、测试执行与跨环境错误修复 |
| **Search-Agent** | 20,000 | 4.1% | 中英文搜索、多跳问答、检索规划与网页信息获取 |
| **合计** | **483,661** | **100%** | |
## 🌟 数据集特点
- **轨迹完整**:除用户指令和最终答案外,保留环境观察、工具调用与返回、错误、重试和最终提交。
- **跨 harness 泛化**:同一类任务在不同 harness、工具集合和系统约束下采样。
- **Turn-level mask**:可对低质量、冗余或格式错误的轮次从 SFT 损失中排除,而不必丢弃整条轨迹。
- **保留诊断性失败样本**:部分超时、工具失败与恢复轨迹经脱敏后作为辅助监督保留,不作为成功示范。
## 🏗️ 数据构建流程
数据集采用统一的任务生成与 Agent 轨迹构建流水线:
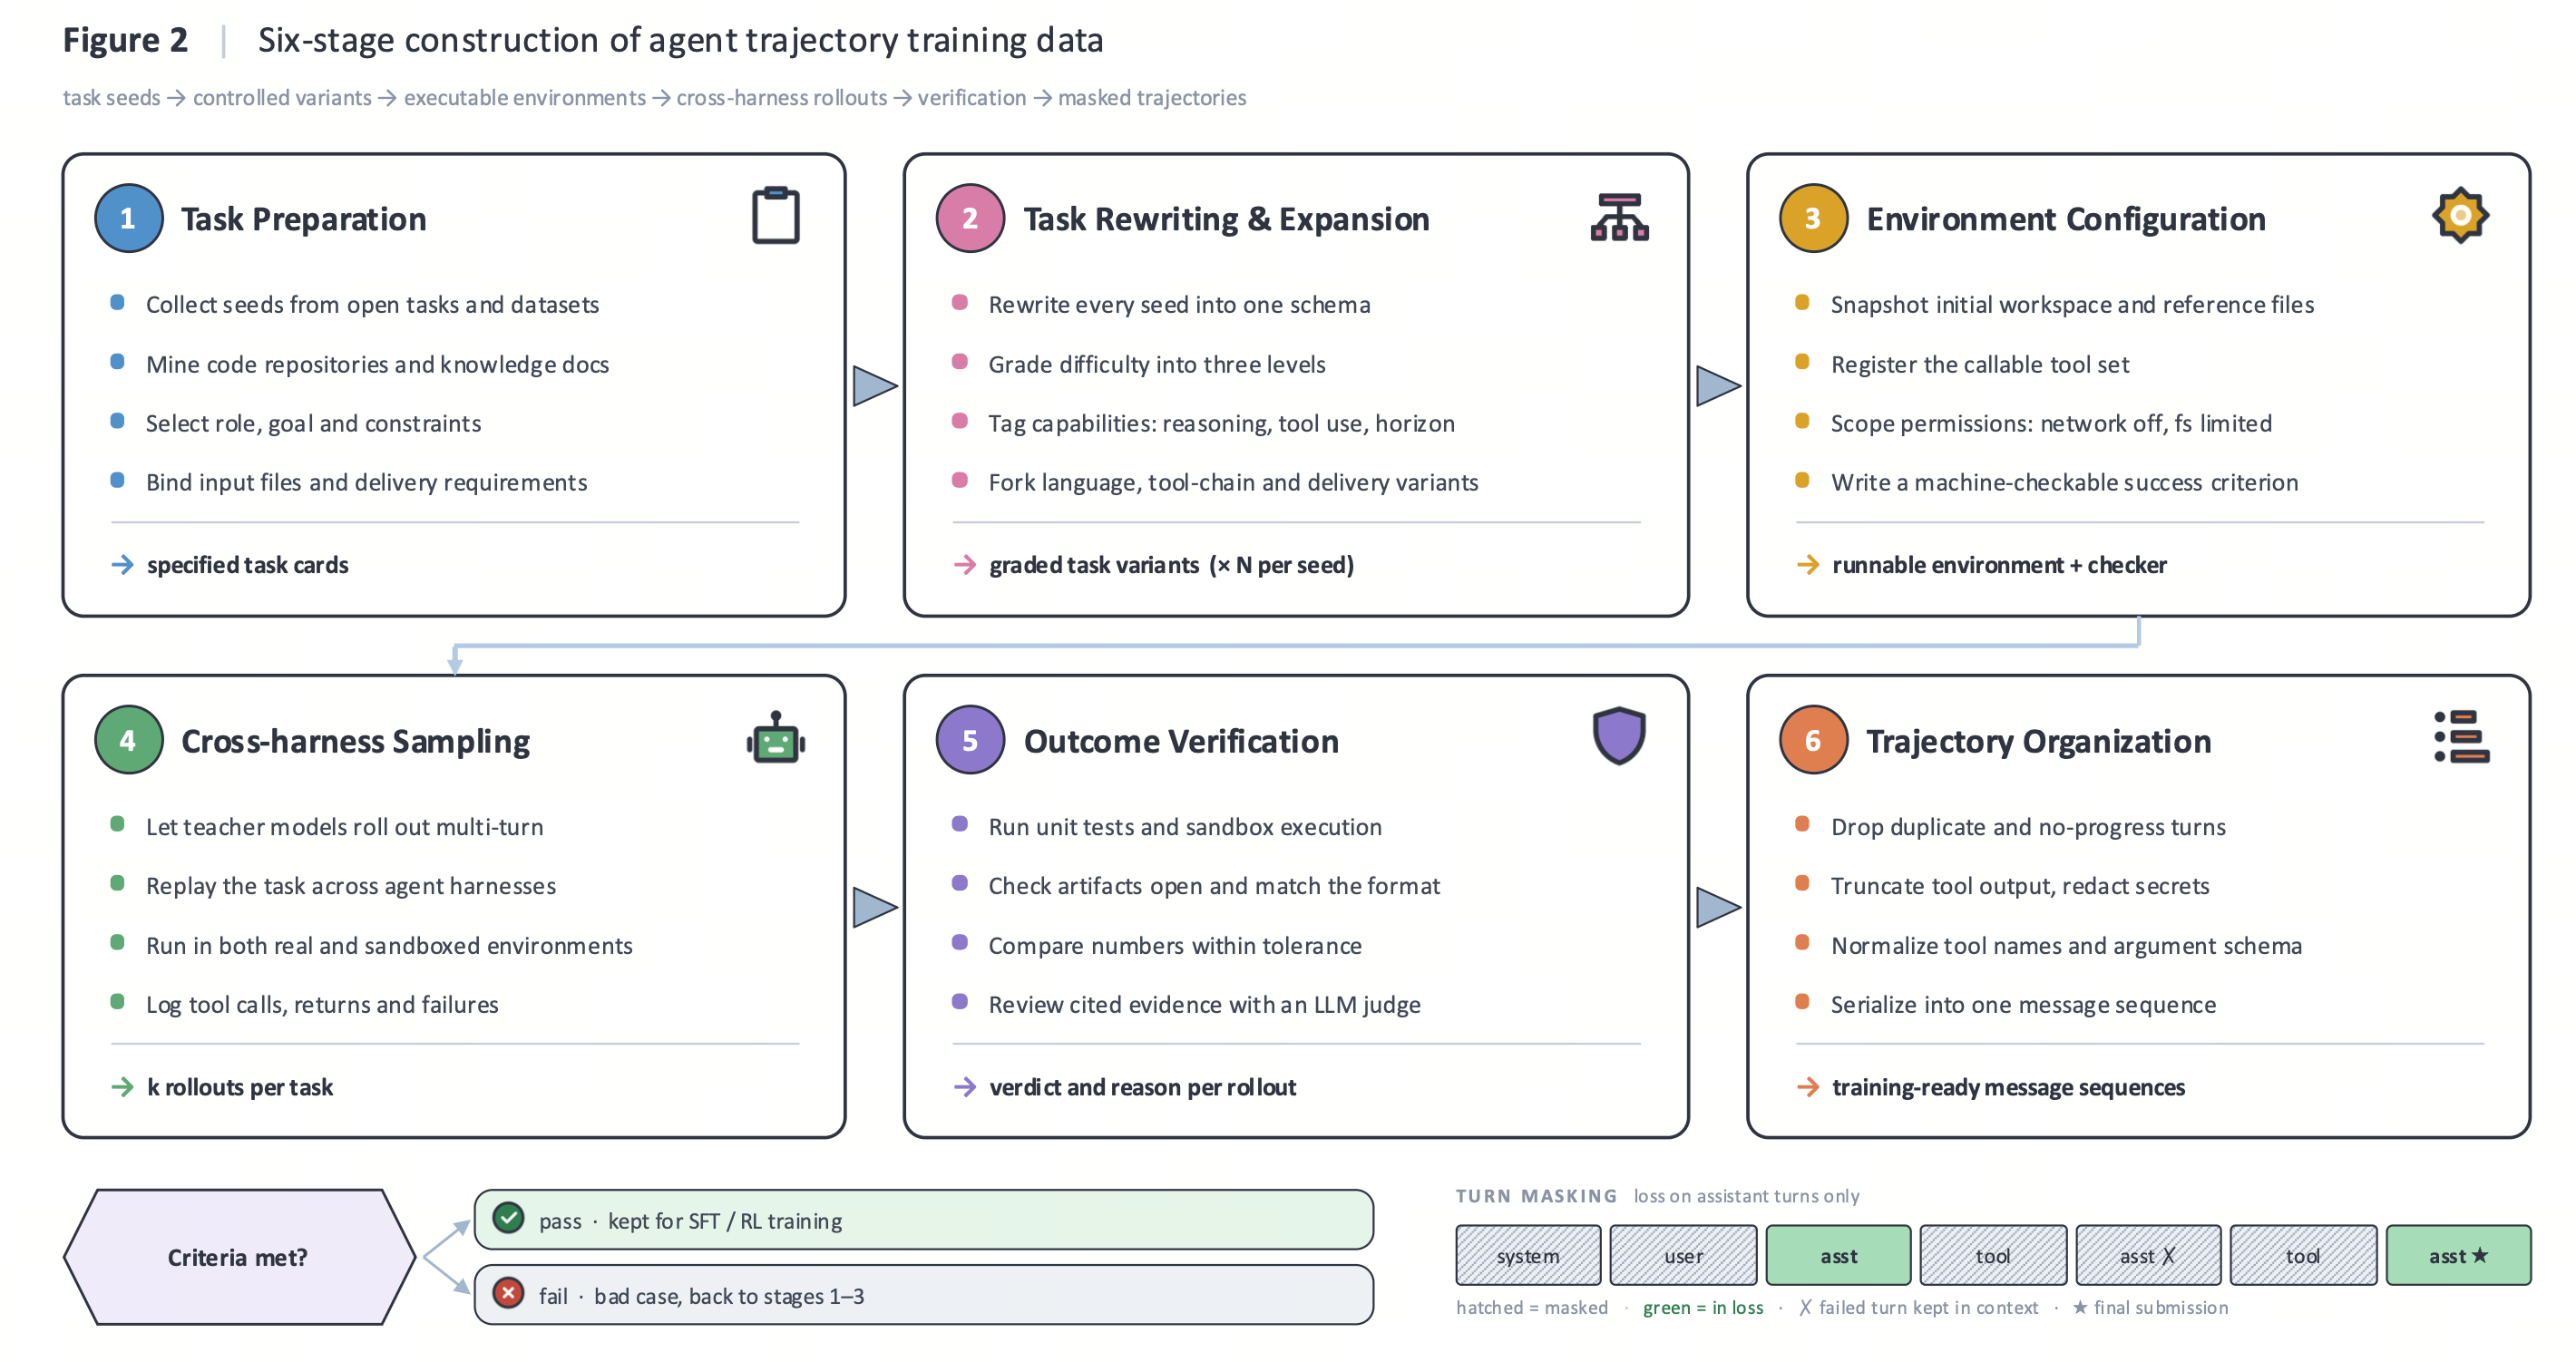
图示按六个步骤展示数据构建过程:任务准备、任务改写与扩展、环境配置、跨 harness 采样、结果验证和轨迹整理。
1. 任务准备:从公开任务、开源数据集、代码仓库、知识资源或人工设计任务中收集任务种子,并补充角色、目标、约束、输入和交付要求。
2. 任务改写与扩展:对任务进行结构化改写、难度分级和能力标注,以生成不同语言、不同任务链路和不同交付形式的任务变体。
3. 环境配置:为每个任务提供初始环境、参考文件、工具集合、权限范围和可执行的成功判定条件。
4. 跨 harness 采样:将任务放入不同 Agent harness 以及真实或仿真环境中,由教师模型完成多轮交互,并采集工具调用、环境反馈和最终结果。
5. 结果验证:按任务类型使用程序测试、沙箱执行、文件可打开性检查、格式规则、数值校验、证据检查或模型评审验证结果。
6. 轨迹整理:将任务指令、环境观察、assistant 行为、工具输入、工具返回、错误和最终提交整理为统一的消息序列。
## 🧹 数据清洗与质量控制
上述流程产出的候选轨迹须通过下列检查方可进入发布版本。检查由自动规则、执行验证与模型审核组合实施,贯穿采样、验证与整理三个阶段,主要包括:
- **格式校验**:检查 JSONL 可解析性、消息角色、必需字段、工具调用格式和参数 schema。
- **轨迹完整性检查**:检查任务指令、assistant 工具调用、工具返回、环境反馈和最终结果是否正确配对。
- **工具行为检查**:过滤不存在的工具、非法参数、无效调用、重复调用、调用循环和与任务无关的工具行为。
- **执行结果验证**:通过沙箱运行、测试用例、文件产物、结构化规则、数值一致性或证据回溯验证任务是否完成。
- **异常轨迹处理**:对超时、环境错误、工具失败、任务中断和错误恢复轨迹进行过滤或规范化标注。
- **Turn-level mask**:对低质量、冗余、重复、格式错误或不应参与监督的交互轮次进行 mask,避免无效信号进入 SFT 损失计算。
- **重复与污染处理**:进行样本去重、近重复检测、跨 split 检查和已知评测集污染筛查。
- **隐私与安全处理**:清理个人信息、账号、密钥、Cookie、内部路径及其他敏感字段,并对危险操作、恶意代码和提示词注入进行标记或过滤。
- **多级质量审核**:结合规则审核、执行结果审核、模型评审和人工抽检,重点保留目标明确、过程可执行、结果可验证的样本。
## 📦 数据格式
每行 JSONL 对应一条完整轨迹。发布版 Meta 为 `uuid`、`messages`、`tools`、`source`、`domain` 五个字段。工具调用、环境观察、思维内容和最终结果均在 `messages` 中。
```json
{
"uuid": "agent_sample_000001",
"messages": [
{"role": "system", "content": "..."},
{"role": "user", "content": "..."},
{"role": "assistant", "content": "...","tool_calls":[...]},
{"role": "tool", "content": "..."},
...
{"role": "assistant", "content": "..."}
],
"tools": [
{
"type": "function",
"function": {
"name": "",
"description": "",
"parameters": {
"type": "object",
"title": "parameters",
"properties": {
"": {
"type": "string",
"title": "",
"description": ""
}
},
"required": [""]
}
}
}
],
"source": "UltraData-SFT-Agent-2609",
"domain": "General_Agent-Office_Agent"
}
```
| 字段 | 类型 | 说明 |
|---|---|---|
| uuid | string | 样本 id。 |
| messages | array | 按时间顺序的 `system` / `user` / `assistant` / `tool` 轮次。 |
| tools | array | 采样时提供的工具定义;训练时需按目标模板写入上下文。 |
| source | string | 数据来源。 |
| domain | string | 取值为 `General_Agent-Claw_Agent`、`General_Agent-Office_Agent`、`Search_Agent-en`、`Search_Agent-zh`、`Search_Agent-plan`、`Tool_Use` 或 `Code_Agent`。 |
部分子集可能保留来源相关的扩展字段,使用时按子集说明映射。
## 🚀 快速开始
```python
from datasets import load_dataset
ds = load_dataset("openbmb/UltraData-SFT-Agent-2609", "Code-Agent", split="train")
ds = load_dataset("openbmb/UltraData-SFT-Agent-2609", "Search-Agent", split="train")
ds = load_dataset("openbmb/UltraData-SFT-Agent-2609", "General-Agent", split="train")
ds = load_dataset("openbmb/UltraData-SFT-Agent-2609", "Tool-Use", split="train")
```
可用 config:`Code-Agent`、`Search-Agent`、`General-Agent`、`Tool-Use`。
## 💡 使用场景
- 面向端侧模型的 Agent SFT,可按 `domain`、工具调用密度和轨迹长度筛选。
- 按切片使用:函数调用(`Tool-Use`)、搜索/多跳检索(`Search-Agent`)、软件工程 Agent(`Code-Agent`)、办公与技能工作流(`General-Agent`)。
- 训练错误恢复与结果验证,包括有意保留的失败/恢复轨迹。
- 与 [UltraData-SFT-2605](https://huggingface.co/datasets/openbmb/UltraData-SFT-2605) 等核心领域 SFT 做配比研究。
## ⚠️ 注意事项与局限性
- **仅静态轨迹**:不包含任务环境、工具实现、测试或采样代码,无法在本地重放或复算验收。
- **须渲染样本自带工具**:`tools` 来自采样 harness,训练时必须写入上下文;许多虚拟 API 在真实部署中并不存在。
- **验证通过 ≠ 过程正确**:通过环境成功判定不代表每一步都正确或高效;保留的失败轨迹不是成功标签。
- **快照时效**:网页、检索结果、文件、依赖与 API 均按采样时刻固化,不宜当作最新事实或版本。
- **去污范围**:仅覆盖构建时已知评测集,引入新基准前应另行检测。
## 📜 许可与数据来源
本项目按 [Apache 2.0](./LICENSE) 许可证发布。数据集汇集上游数据集、公开代码仓库、网页内容与模型生成轨迹;使用者还须遵守各上游许可证。Apache 2.0 不会覆盖或取代这些条款。
部分样本来自公开可访问的课程页面。公开可访问不等于授予再分发、商用或训练许可。权利人可通过数据集页面的联系方式申请移除。
数据集不应包含明文密钥或未经授权的个人数据。敏感内容或删除请求请通过同一渠道联系维护者。
**禁止未经授权的原样转载:** 未经原作者(或本组织)事先书面许可,任何机构、组织或第三方平台严禁以任何形式直接转载、镜像、重新托管,或对项目产物进行商业化重新包装后再发布。
## 📖 引用
如果 **UltraData-SFT-Agent-2609** 对您的研究有帮助,请考虑引用:
```bibtex
@misc{ultradata_sft_agent_2609,
title = {UltraData-SFT-Agent-2609},
author = {MiniCPM Team},
year = {2026},
publisher = {Hugging Face},
howpublished = {\url{https://huggingface.co/datasets/openbmb/UltraData-SFT-Agent-2609}}
}
```
